
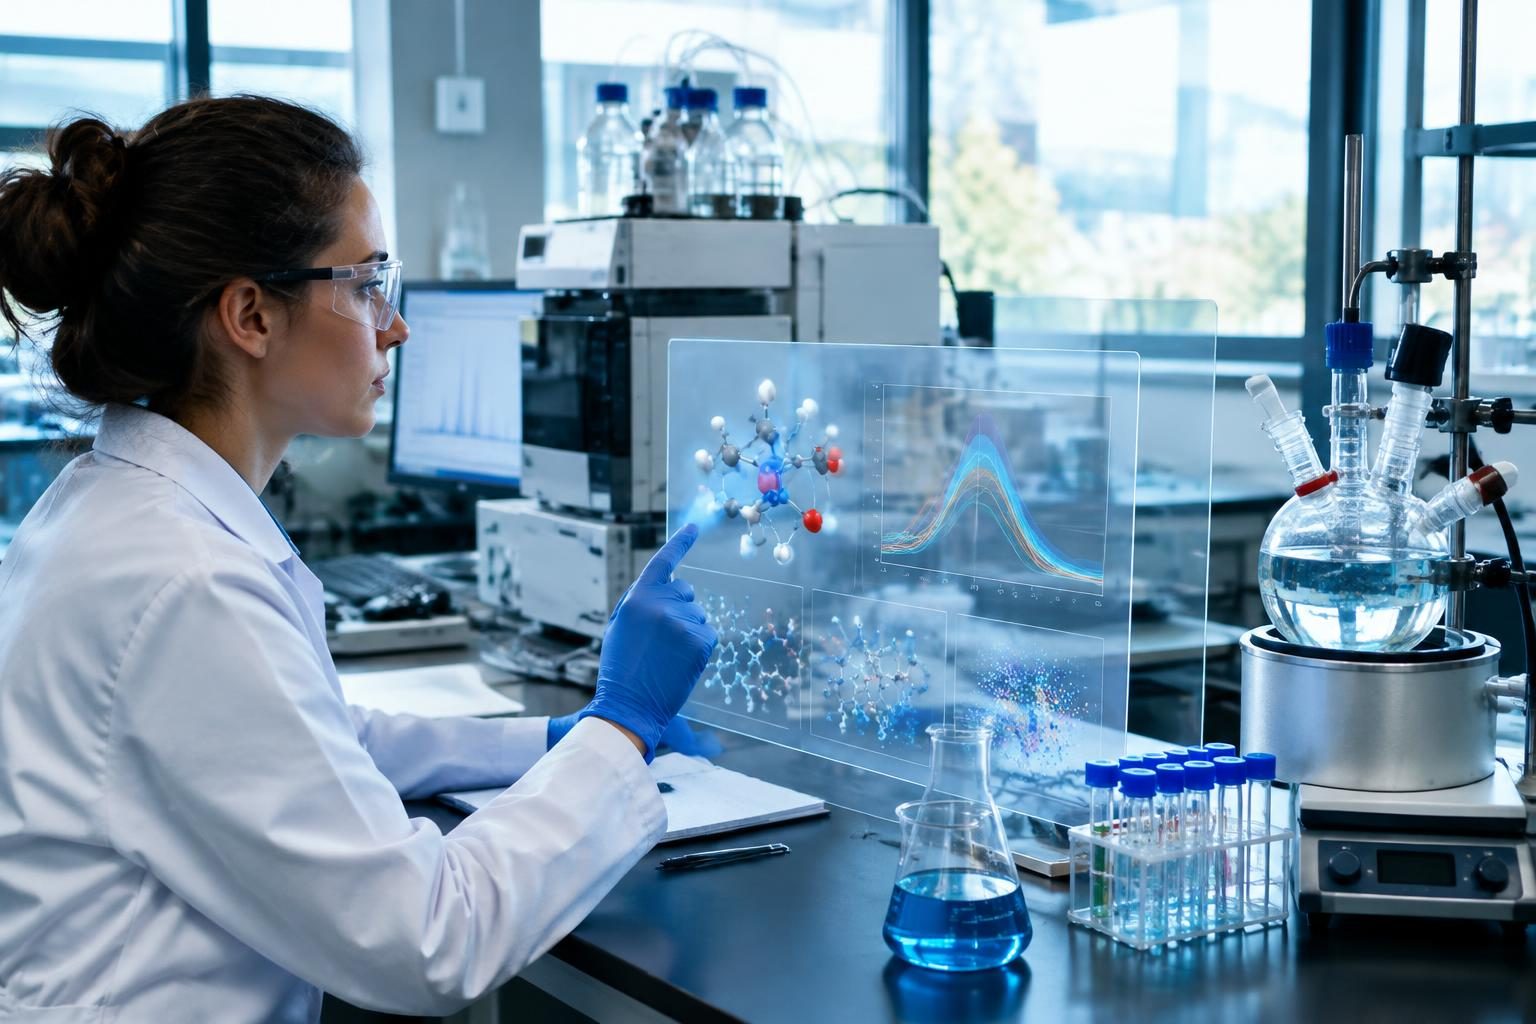
L’intelligenza artificiale può ridurre il tempo necessario per cercare molecole, materiali e reazioni promettenti, ma non sostituisce la verifica sperimentale. È questo il punto centrale di una recente analisi pubblicata su Chemical Society Reviews, realizzata da ricercatori di Skoltech, dell’Istituto di chimica organica Zelinsky, dell’Università ITMO e di altre istituzioni.
Il valore concreto dell’IA in laboratorio
Nella ricerca chimica, l’IA non è un unico strumento. Comprende modelli statistici, reti neurali, sistemi di apprendimento automatico e modelli generativi capaci di proporre strutture molecolari o condizioni di reazione. Il loro vantaggio principale è la velocità con cui possono esaminare grandi quantità di dati.
Un ricercatore può impiegare questi sistemi per prevedere proprietà di una molecola, stimare la resa di una reazione, individuare materiali con determinate caratteristiche oppure restringere il numero di esperimenti da eseguire. In settori come la catalisi, l’energia e la scoperta di farmaci, questa selezione preliminare può avere un valore pratico importante.
L’IA è inoltre utile nell’analisi di immagini, spettri e risultati provenienti da strumenti automatici. In alcuni casi riconosce correlazioni difficili da individuare a occhio, soprattutto quando i dati sono numerosi e raccolti con protocolli uniformi.
Perché una previsione non è una prova
Il limite emerge quando il modello viene valutato su dati troppo simili a quelli usati durante l’addestramento. Una prestazione elevata in un test informatico può riflettere la capacità di riconoscere schemi già presenti nel campione, senza dimostrare che il sistema sappia funzionare su molecole, strumenti o condizioni completamente nuove.
In chimica, il passaggio dal calcolo al banco di laboratorio è particolarmente delicato. La resa di una reazione dipende spesso da fattori che non compaiono nei database: purezza dei reagenti, umidità, forma del recipiente, velocità di aggiunta, agitazione, temperatura reale e abilità dell’operatore.
Anche una piccola variazione può modificare il risultato. Un modello può suggerire una combinazione plausibile di reagenti, ma non sapere se una sostanza è instabile all’aria, se un sottoprodotto ostacola la purificazione o se una reazione richiede un passaggio preliminare non documentato.
I dati determinano la qualità del risultato
I modelli apprendono dai dati disponibili. Se i dati sono incompleti, sbilanciati o ottenuti con metodi diversi, anche le previsioni possono diventare fragili. Nei database chimici sono spesso sovrarappresentate le reazioni riuscite e pubblicate, mentre gli esperimenti falliti rimangono meno visibili.
Questa selezione crea un problema: il sistema può imparare che determinate condizioni sono associate al successo senza comprendere quanto spesso producano risultati negativi. Inoltre, due laboratori possono descrivere la stessa procedura con livelli di dettaglio differenti, rendendo difficile confrontare gli esperimenti.
Per questo non basta indicare l’accuratezza media di un algoritmo. Occorre sapere su quali molecole è stato testato, quanto è distante il nuovo caso dai dati di addestramento, quali errori produce e con quale incertezza formula le previsioni.